01
如何将时序任务与人类意图转化为反馈约束?
高层需求描述顺序、期限、持续、恢复和交互关系。研究相应语义与编译方法,将需求转化为可处理的优化、屏障函数、Lyapunov、自动机或模型预测控制约束。
研究满足显式时序任务、安全约束、鲁棒性要求和人机交互目标的学习增强规划与反馈控制方法。
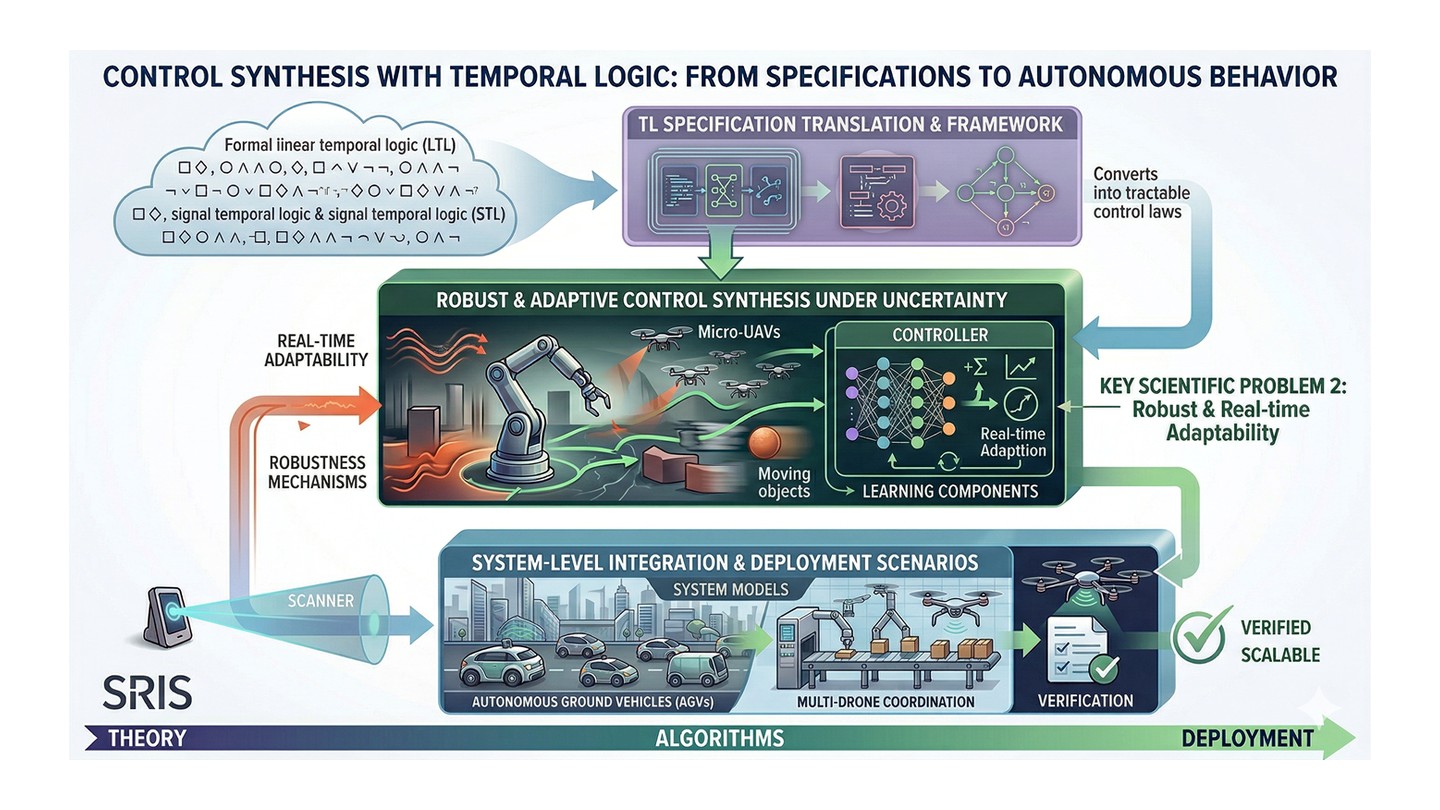
本方向融合控制理论、形式化方法、优化、强化学习、离散事件综合和机器人学习。安全与任务满足不是部署后的附加评价,而是控制器设计时的基本约束。
应用涵盖非线性与混杂系统、机器人操作、协作与可穿戴机器人、制造调度、容错运行以及多自主平台协同。
高层需求描述顺序、期限、持续、恢复和交互关系。研究相应语义与编译方法,将需求转化为可处理的优化、屏障函数、Lyapunov、自动机或模型预测控制约束。
神经策略和强化学习具有适应性,但可能在训练分布之外违反约束。研究将学习与 CLF/CBF 过滤器、鲁棒 MPC、形式综合、递归可行性和不确定性自适应结合,使性能提升始终位于显式安全包络内。
机器人操作、调度、多智能体协同和共享自主同时耦合离散决策与连续动力学。研究分层分解、图推理、容错、实时修复和人类控制权保持,实现可扩展部署。
时序规范、人类意图、系统动力学、故障与资源约束
可达性、屏障裕度、递归可行性、不确定集与离散事件结构
MPC、CBF/CLF、强化学习、形式化与分层控制
安全运动、韧性运行、协同自主与以人为中心交互